El viernes retomé un plan de varias semanas que llevaba tiempo “atrancado” por otros proyectos. A mediodía dejé escrito a dónde quería llegar en la fase que estaba desarrollando, luego le pasé ese objetivo a Claude Code con /goal y lo solté. Unas cuatro horas y 23 commits después, la parte del plan que dependía de código estaba hecha y desplegada en el entorno de pruebas. Mi participación fue prácticamente nula: aprobar permisos cuando me los pedía.
No creo que haya funcionado por el modelo. Funcionó porque antes de empezar había escrito cómo me lo imaginaba “terminado”, en una nota que se llama PLAN.md (hablo más de eso en el-contexto-es-mio). Esta nota es para eso: qué escribo antes de soltar a un agente, cómo decide cada herramienta que el trabajo terminó, y qué pasa cuando no le doy ningún objetivo.
La meta la escribo yo. Cada agente construye su camino. Ilustración original generada con IA.
Lo aprendí evaluando modelos
Este vicio de escribir cómo me imagino el final viene de los proyectos de ML: antes de entrenar un modelo de machine learning escribo cómo lo voy a evaluar: contra qué método base, con qué métrica, en qué horizonte y qué cuenta como empate. Si lo decido después de ver el resultado, el resultado decide por mí, y siempre encuentro una forma de leerlo a mi favor. En hace-anos-no-escribo-import-pandas conté lo difícil que es ganarle a un método simple; justamente por eso la regla de comparación tiene que existir antes que el número.
Con un agente es lo mismo. Si "terminado" no está escrito, el que decide cuándo parar es el agente, o soy yo mirando la pantalla cada diez minutos. Ninguna de las dos me sirve para soltarlo.
Qué tiene un objetivo que se puede soltar
El plan del viernes no era una lista de deseos. Tenía una tabla por semana, cada brecha con su criterio de salida, una sección de riesgos y un supuesto escrito como supuesto (“por confirmar”), para que el agente no lo tratara como un hecho. Lo que le paso a /goal es corto, porque el detalle vive en ese documento. Este es el formato que uso:
Objetivo: <a dónde quiero llegar, en una frase>
Plan: <ruta al documento con los pasos; el agente lo actualiza al avanzar>
Terminado cuando: <condiciones verificables: pruebas, un comando, una métrica con umbral>
Evidencia: <qué tiene que quedar a la vista para probarlo, por ejemplo la salida de las pruebas>
No tocar: <producción, datos reales, la rama principal, secretos>
Parar y preguntar si: <una decisión de negocio, un cambio de alcance, algo irreversible>
Límite: <o después de N turnos>
Las líneas que más trabajo hacen son tres:
- Terminado cuando. Tiene que ser algo que se pueda comprobar, no algo que se pueda opinar. “Todas las pruebas pasan y el despliegue en pruebas responde” sirve. “Que quede bien” no. Y ojalá algo numérico: decirle que itere hasta que quede “bonito” o “estético” funciona a medias, porque es un criterio muy subjetivo.
- Parar y preguntar si. Es lo que me deja irme. Un agente que no sabe cuándo escalar hace una de dos cosas: se detiene por cualquier duda o decide solo cosas que no le tocan.
- Límite. Ninguna de estas herramientas trae por defecto un tope de turnos que me sirva. Si no lo escribo, el objetivo puede consumir la tarde (y la suscripción) persiguiendo algo imposible. Me ha pasado: cuando no logra el objetivo, se queda iterando y gastando mis preciosos tokens. Una vez, tratando de mejorar un modelo de ML, le puse como objetivo bajar el error un 5 %. El techo que alcanzó fue 2 %, y como no era capaz, se quedó iterando toda la noche hasta gastarse todos mis tokens de la semana.
La parte más “maluca” del proceso puede ser escribir el PLAN.md, pero para eso tengo otro trucazo: la skill /grill-me de Matt Pocock, que básicamente me hace una entrevista y, con mis respuestas, crea el documento con un nivel de detalle que les facilita a los agentes guiarse.
Quién decide que terminó
/goal existe en las tres herramientas que uso, pero no funciona igual en todas, y la diferencia importa más que el nombre del comando.
- Claude Code. Después de cada turno, un modelo pequeño y rápido lee la conversación y responde sí o no a la condición (documentación). No ejecuta nada por su cuenta: solo ve lo que quedó escrito. Por eso la documentación pone como ejemplo “todas las pruebas en test/auth pasan”, que funciona porque Claude corre las pruebas y el resultado aparece en la conversación. Si la condición no se puede comprobar leyendo, el evaluador está adivinando. La condición admite hasta 4.000 caracteres, y en modo manual Claude sigue pidiendo permiso para lo que la configuración no autoriza; eso fue lo único que me pidió el viernes.
- Codex. Por lo que he leído (acá lo explican bien), es el propio agente el que marca el objetivo como cumplido, sin un evaluador aparte, y tiene pausa, reanudación y un presupuesto de tokens. La implementación es distinta, pero en mis ensayos se comporta parecido al de Claude: funciona muy bien, y lo uso a la par para no volverme dependiente de uno solo.
- Hermes. También tiene
/goalpara sostener un objetivo durante varias rondas. Con Hermes uso lo mismo que con los otros dos: unPLAN.mdbien escrito.
La diferencia de fondo es quién juzga. En Codex juzga el mismo que trabaja; en Claude Code juzga otro modelo, pero solo con lo que el primero le muestra. En los dos casos la defensa es la misma: escribir la condición en términos de evidencia que quede a la vista, no de afirmaciones del agente.
Soltarlo sin objetivo: “sorpréndeme en la mañana”
Lo contrario también me sirve. Hay un truco que le recomendé a un amigo: antes de dormir, le digo al agente “/goal haz algo durante la noche que me sorprenda en la mañana”. Sirve para aprovechar la suscripción en horas en que no la estoy usando y, de paso, para ver de qué es capaz un modelo nuevo sin dirigirlo. Lo uso para probar modelos, siempre con un límite, por lo que conté arriba de los tokens.
Con Hermes, y su propio /goal, el resultado fue Café Nube: un café de gatos en pixel art, dibujado rectángulo por rectángulo en un lienzo de 240 × 160 píxeles, sin ninguna dependencia, en unas 1.500 líneas de JavaScript.
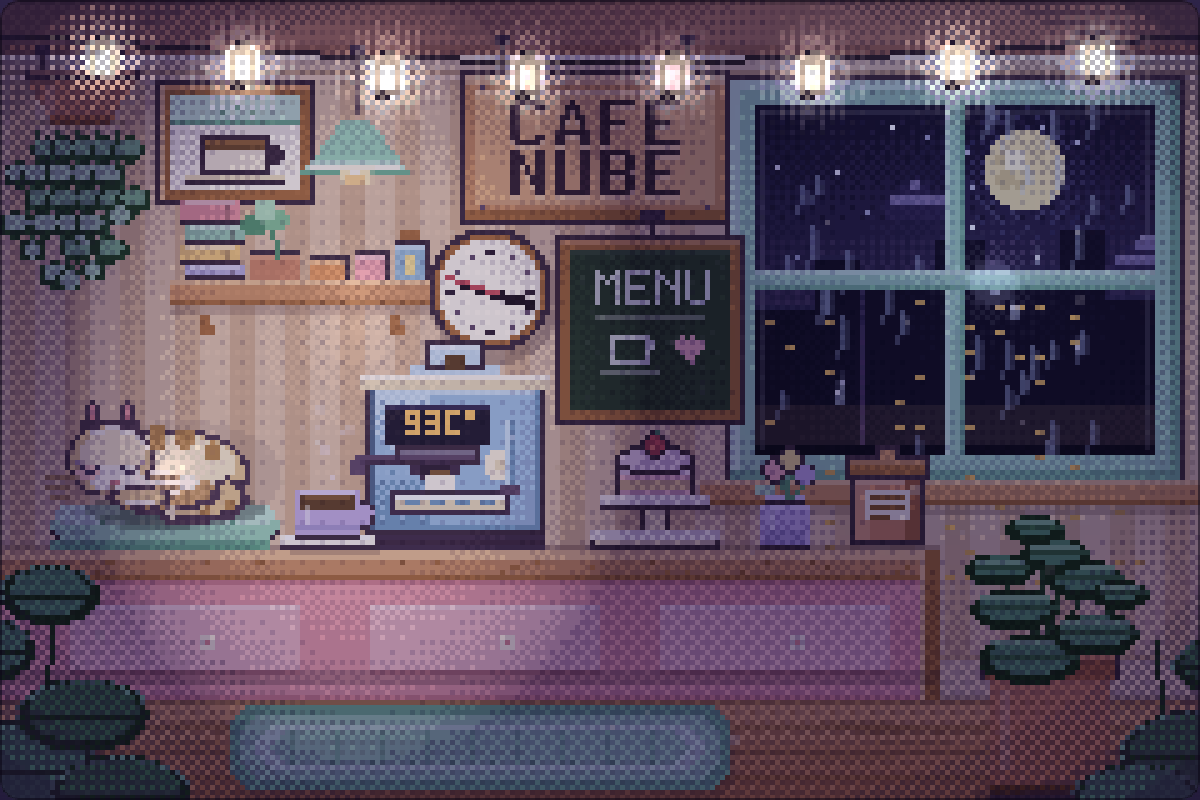
Café Nube, hecho por un agente sin instrucciones más allá de “sorpréndeme”.
Lo que más me sorprendió no fue la imagen. Fue que, sin que nadie se lo pidiera, armó su propio ciclo de revisión: unas treinta capturas, ampliaciones de cada esquina a 3× y 4×, el gato redibujado en seis versiones y el letrero en cinco. Sin objetivo de mi parte, se puso uno.
No es productivo, y no tiene que serlo. No todo lo que hago tiene que generar valor; esto lo disfruté. Pero si lo van a probar, con algunas condiciones: una carpeta o rama propia, sin credenciales, sin permiso para publicar ni desplegar, y que deje un resumen de lo que hizo para leer en la mañana. Un agente toda la noche con permisos amplios no es un experimento divertido, es un riesgo.
Dónde falla
- El agente comprime el código, no el cuello de botella. El plan del viernes tenía dos columnas: lo que hacía el equipo y lo que dependía de otras áreas (permisos, infraestructura, usuarios que prueben). La primera se hizo en una tarde; la segunda quedó exactamente igual. Cuatro horas de código no mueven una fecha que depende de una solicitud que nadie ha aprobado. El Rubén del futuro tendrá que gestionar lo que falta.
- La revisión es el costo que no se ve. Veintitrés commits en una tarde son veintitrés commits que alguien tiene que leer. Soltar al agente no elimina ese trabajo, lo mueve para después. Otra vez, trabajo para el Rubén del futuro.
- La evidencia puede ser decorativa. Si la condición dice “las pruebas pasan” y el agente solo lo afirma, un evaluador que lee la conversación no tiene cómo distinguirlo. Por eso pido la salida, no la frase.
- Un plan malo se ejecuta igual de rápido. Todo esto funciona porque el plan estaba bien pensado. Si el plan tiene un error de fondo,
/goallo implementa con la misma disciplina.
En el-contexto-es-mio escribí que el modelo cambia y el contexto es mío. Esto es la otra mitad: el criterio de terminado también es mío. El agente puede trabajar solo toda la tarde, pero la frase que dice cuándo parar la escribo yo, y la escribo antes.